
Robots.txt je jako cedule na dveřích e-shopu: tudy ano, tudy ne! A roboti (crawleři) ji většinou respektují a berou jako doporučení, které jim pomůže neplýtvat jejich časem (crawl budgetem). Není to však directiva, takže čas od času se stane, že ji ignorují.
Robots.txt v Shoptetu doporučuji ve většině případů nechat v jeho výchozím nastavení. Shoptet už automaticky blokuje technické části administrace, košík, přihlášení, interní vyhledávání, řazení a velkou část parametrických URL, které by vyhledávače zbytečně procházely.
Soubor robots.txt najdete na každém Shoptet e-shopu jednoduše přidáním /robots.txt za doménu. U Dudlu je tedy veřejně dostupný na adrese www.dudlu.cz/robots.txt. Soubor je veřejný, protože ho před návštěvou webu potřebují přečíst Googlebot, Bingbot, SeznamBot a další crawlery.
Nově Shoptet přidal také nastavení Content Signals pro klasické vyhledávání, použití obsahu v AI odpovědích a trénování AI modelů. A právě tím se z nenápadného technického souboru, na který deset let skoro nikdo nesahal, stal znovu předmět SEO debat. Pojďme si tedy vysvětlit, co robots.txt skutečně dělá, co rozhodně nedělá a kam raději nestrkat ruce bez dozoru seniorního SEO specialisty.

Jak nastavit Robots.txt v Shoptetu (Autor: Tomáš Zahálka)
Co je robots.txt?
Robots.txt je textový soubor v kořenovém adresáři webu, který automatickým crawlerům říká, které URL smějí a nesmějí procházet. Jde o takzvaný Robots Exclusion Protocol. Robot před procházením webu načte soubor robots.txt, zjistí pravidla určená pro svůj User-agent a podle nich se rozhodne.
Robots.txt ale není bezpečnostní zámek ani firewall. Pravidla respektují Google, Bing a další slušně vychovaní roboti, ale technicky nikomu nezabrání adresu otevřít. Pokud máte tajný ceník pro B2B zákazníky, osobní data nebo stránku, kterou skutečně nesmí nikdo nepovolaný vidět, robots.txt není ochrana. Takovou stránku musíte zabezpečit přihlášením, heslem nebo na úrovni serveru.
A hlavně: robots.txt primárně řídí crawling, nikoliv indexaci. Google výslovně upozorňuje, že URL zakázanou přes robots.txt může za určitých okolností stále zařadit do indexu, pokud její adresu objeví například prostřednictvím odkazů. Obsah stránky sice nepřečte, ale samotnou URL může znát.

Co je Robots.txt a jak ovlivňuje e-shop
Jak vypadá výchozí robots.txt v Shoptetu?
Výchozí nastavení Shoptetu považuji pro naprostou většinu e-shopů za správně navržené. Jeho smyslem je nechat crawlery procházet produkty, kategorie, články a další obsahové stránky, ale odříznout technické URL a různé kombinace parametrů, které pro organické vyhledávání nemají smysl.
User-agent: *
Disallow: /export/
Disallow: /admin/
Disallow: /script/
Disallow: /api/
Disallow: /action/
Disallow: /*?priceMax
Disallow: /*?priceMin
Disallow: /*?parameterId
Disallow: /*?order
Disallow: /*?availabilityId
Disallow: /*?manufacturerId
Disallow: /*?stock
Disallow: /*?pv*=*,
Disallow: /*&pv*=*,
Disallow: /*?pv*=*&pv*=
Disallow: /*&pv*=*&pv*=
Disallow: /*:*,*/
Disallow: /*/?backTo=
Disallow: /*?dd=*,
Disallow: /*&dd=*,
Disallow: /*?dd=*&pv*=
Disallow: /*?pv*=*&dd=
Disallow: /*/?letter=*
Disallow: /vyhledavani/
Disallow: /kosik/
Disallow: /login/
Disallow: /registrace/
Disallow: /klient/zapomenute-heslo/
Disallow: /affiliate-registrace/
Disallow: /affiliate-zapomenute-heslo/
Disallow: /uzivatel/
Disallow: /klient/moje-objednavka/
Disallow: /affiliate/accounts/
Disallow: /affiliate/scripts/

Disallow: /*:diskuse
Disallow: /*:dotaz
Disallow: /*:hlidat-cenu
Disallow: /*:klient-hodnoceni
Disallow: /*:moznosti-dopravy
Disallow: /*:wysiwyg

Sitemap: https://www.vaseshop.cz/sitemap.xml
Co znamenají příkazy v robots.txt?
Základ robots.txt tvoří čtyři pojmy: User-agent, Disallow, Allow a Sitemap. Google podporuje právě tyto základní direktivy pro řízení crawlingu a velké vyhledávače pracují se stejným principem. Každá má jiný význam a jedna špatně napsaná řádka může ovlivnit tisíce URL.
| Direktiva | Co znamená |
|---|---|
| User-agent | Určuje, pro kterého robota pravidla platí. |
| Disallow | Zakazuje crawleru procházet odpovídající URL. |
| Allow | Povoluje konkrétní URL nebo výjimku uvnitř širšího zákazu. |
| Sitemap | Ukazuje robotům adresu XML sitemapy. |
(1.) Co znamená User-agent?
User-agent určuje, kterému crawleru jsou následující pravidla určena. Hvězdička v zápisu User-agent: * znamená obecně všechny roboty, kteří se podle tohoto protokolu řídí. Můžete ale vytvořit samostatnou skupinu například pro Googlebot nebo jiného konkrétního robota.
User-agent: *
Disallow: /kosik/
Tento příklad říká všem robotům, aby neprocházeli adresy začínající cestou /kosik/.
(2.) Co znamená Disallow?
Disallow znamená „tuto cestu neprocházej“. Například Disallow: /admin/ crawlerům říká, že nemají požadovat URL začínající /admin/. Nezakazuje pouze jednu přesnou stránku, ale celou cestu.
Právě tady je potřeba dávat pozor na příliš široké zápisy. Direktiva Disallow: / znamená zákaz crawlingu celého webu pro danou skupinu robotů. Jeden znak a SEO specialista má o zábavu postaráno.
(3.) Co znamená Allow?
Allow vytváří povolení nebo výjimku z širšího pravidla. Pokud byste například zakázali celou složku, ale jednu konkrétní část v ní chtěli robotovi zpřístupnit, může se použít Allow. Při konfliktu pravidel Google vyhodnocuje konkrétnější cestu a při podobných konfliktních pravidlech volí méně restriktivní variantu.
Na běžném Shoptetu vlastní Allow většinou vůbec nepotřebujete. A za chvíli ukážu, proč může být například dobře míněné Allow: / pro konkrétní AI crawler dokonce problém.
(4.) Co znamená Sitemap?
Direktiva Sitemap ukazuje vyhledávačům adresu XML sitemapy webu. Shoptet ji generuje automaticky a v robots.txt proto najdete například Sitemap: https://www.dudlu.cz/sitemap.xml. Sitemap robotům pomáhá s objevováním důležitých URL, zatímco robots.txt naopak říká, kam lézt nemají.
Může být trochu matoucí, že v Robots.txt, kde jsou zákazy, se objeví Sitemapa, kterou naopak chcete procházet, ale je to tak správně. Vyhledávače ji tam standardně očekávají a hledají.
SEO pro Shoptet e-shopy od týmu Tomáše Zahálky
Co znamenají hvězdičky, otazníky a další znaky?
Nejdůležitější speciální znak je hvězdička *, která zastupuje nula nebo více libovolných znaků. Díky ní lze jedním pravidlem zakázat velké množství různých URL, aniž byste je museli vypisovat po jedné.
| Znak | Význam | Příklad |
|---|---|---|
| * | Nula nebo více libovolných znaků | /*?order |
| $ | Konec URL | /*.pdf$ |
| ? | Běžná součást URL označující začátek query parametrů | ?order=price |
| & | Odděluje další query parametr v URL | ?barva=modra&size=L |
| # | Začátek komentáře v robots.txt | # Poznámka pro SEO |
| / | Cesta od kořene webu | /kosik/ |
Otazník ? není v tomto případě zástupný znak. Je to normální součást URL, která odděluje cestu stránky od parametrů. Pokud tedy Shoptet používá Disallow: /*?order, hvězdička znamená „před tím může být prakticky jakákoliv cesta“ a ?order říká, že se pravidlo týká URL, tykající se řazení.
Ampersand & funguje podobně, ale odděluje další parametr. Proto výchozí robots.txt obsahuje varianty pravidel začínajících jak ?, tak &. Parametr totiž může být na URL první, ale také druhý, třetí nebo sedmnáctý. E-shopaři milují filtraci, crawlery díky ní občas objeví paralelní vesmír URL.
Dolar $ znamená konec URL. Ve výchozím Shoptet robots.txt ho aktuálně prakticky nepotřebujete, ale při vlastních pravidlech se s ním můžete setkat.
Mřížka # vytváří komentář. Vše za ní na daném řádku crawler ignoruje. Hodí se proto například pro vysvětlení, proč jste nějaké vlastní pravidlo přidali. Za dva roky pak SEO specialista nemusí přemýšlet, jestli tajemné Disallow vytvořil váš bývalý kodér, účetní nebo synovec, který „umí počítače“.
Proč Shoptet blokuje tolik URL?
Protože ne každá URL, kterou může zákazník nebo systém vytvořit, má být vstupní stránkou z Googlu. E-shop generuje obrovské množství technických, uživatelských a parametrických adres. Robot by bez pravidel mohl trávit čas jejich procházením místo produktů, kategorií a článků, které mají hodnotu.
(1.) Technické části Shoptetu
Adresáře jako /admin/, /api/, /action/, /script/ nebo /export/ nejsou obsahové landing pages. Vyhledávač nepotřebuje indexovat administrační nebo systémové cesty.
(2.) Košík, přihlášení a zákaznický účet
Stejnou logiku mají zákazy /kosik/, /login/, /registrace/, uživatelských účtů nebo obnovení hesla. Tyto stránky jsou důležité pro zákazníka a UX, ale pro SEO a organicu nemají význam.
(3.) Interní vyhledávání
Shoptet správně blokuje také /vyhledavani/. Interní vyhledávání dokáže vytvořit obrovské množství URL podle toho, co člověk zadá do vyhledávacího políčka. Pokud byste crawlery nechali procházet každou kombinaci, začnou zběsile indexovat duplicity a nastane kanibalizace e-shopu.
(4.) Řazení, ceny, výrobci a dostupnosti
Parametry jako ?order, ?priceMin, ?priceMax, ?manufacturerId, ?availabilityId nebo ?stock často pouze mění zobrazení stejné základní kategorie. Bez omezení by například jedna kategorie mohla existovat v mnoha variantách podle řazení ceny, dostupnosti nebo výrobce.
Google sám upozorňuje, že parametrická neboli faceted navigation může vytvářet prakticky nekonečný prostor URL. Robot nejprve neví, zda je nová kombinace užitečná, a proto ji může zkusit projít. Čím více bezcenných kombinací web nabídne, tím více crawler budgetu padá na neůrodnou půdu.
(5.) Parametrická filtrace pv
Pokud chcete nějakou filtraci cíleně dostat do organického vyhledávání, není správná cesta začít bezhlavě povolovat ?pv URL v robots.txt. Na Shoptetu se k tomu používá Pokročilé SEO, které z relevantní kombinace vytvoří smysluplnou vstupní stránku s vlastní nice URL a obsahem.
Co je crawl budget a proč robots.txt pomáhá?
Crawl budget je zjednodušeně množství URL, které Google na vašem webu chce a může v určitém období procházet. Google ho skládá mimo jiné z kapacity webu a poptávky po crawlingu. Pokud robot zná milion zbytečných URL, může jejich procházení zpomalit objevování důležitého obsahu.
U běžného malého Shoptet e-shopu bych z crawl budgetu nedělal SEO strašáka. Google sám uvádí, že jeho pokročilé řešení crawl budgetu je důležité hlavně pro opravdu velké nebo velmi rychle se měnící weby – orientačně například miliony URL nebo desetitisíce stránek s každodenními změnami.
To ale neznamená, že máme robotům úmyslně servírovat bordel. U e-shopů je podstatná hlavně efektivita crawlingu a prevence nekonečných kombinací filtrů. Kategorie s deseti filtry může matematicky vytvořit mnohem více URL, než kolik máte reálných produktů.

Marketingové konzultace a audity pro Shoptet e-shopy od Tomáše Zahálky
Proč GSC hlásí stránky blokované robots.txt?
Protože přesně to po Googlu chcete. Jednou za čas mi klient pošle screenshot z Google Search Console s desítkami nebo tisíci URL a vystrašenou zprávou, že „Google hlásí chyby v indexaci“.
Hláška „Blocked by robots.txt“ automaticky neznamená SEO problém. Znamená, že Google URL zná, pokusil se vyhodnotit její dostupnost a pravidlo robots.txt mu nedovoluje obsah projít. Pokud jde o košík, login, interní vyhledávání nebo nepotřebnou parametrickou kombinaci, je to správný stav.
V Search Console tedy vždy řešte konkrétní typ URL, ne pouze počet „neindexovaných stránek“. E-shop se 20 000 produkty může mít klidně mnohem více známých URL kvůli filtrům, řazení, stránkování, uživatelským akcím a dalším technickým kombinacím. Cílem není dostat do indexu všechno, co server dokáže vygenerovat. Cílem je dostat tam správné landing pages.
Jak se může zakázaná URL přesto dostat do indexu?
Robots.txt brání crawleru stránku přečíst, ale nezabraňuje mu zjistit, že URL existuje. Google může adresu objevit například z odkazu na jiné stránce. Proto může za určitých okolností vzniknout situace, kdy je URL známá nebo dokonce indexovaná, přestože její obsah Googlebot kvůli robots.txt neprošel.
V praxi to na Shoptetu občas vidíme u parametrických filtrací nebo interního vyhledávání. Samotný tvar URL je správně blokovaný, ale majitel e-shopu si například otevře filtr, zkopíruje adresu z prohlížeče a vloží ji jako interní odkaz do popisu kategorie, produktu nebo článku.
Vyhledávači tím posíláte dvě protichůdné informace: robots.txt říká „sem nelez“, ale interní odkaz říká „tahle stránka je důležitá, tady máš pěkný anchor text a běž se podívat“.
Podobné případy jsou sice v praxi spíš jednotky procent, ale o to hůř se hledají. Robots.txt vypadá správně, Search Console hlásí podivnou URL a problém nakonec najdete v ve starém článku.

? PPC pro Shoptet e-shopy už od 10 000 Kč měsíčně (PPC tým: Tomáš Zahálka)
Proč neodkazovat na URL zakázané v robots.txt?
Interní prolinkování by mělo směřovat především na indexovatelné a pro SEO hodnotné stránky. Pokud odkazujete na URL, kterou současně robotům blokujete, vytváříte zbytečně nekonzistentní signál a posíláte uživatele na adresu, kterou jste si sami označili jako nevhodnou pro crawling.
Na Shoptetu se to nejčastěji děje dvěma způsoby: odkazem na dynamickou filtraci a odkazem na interní vyhledávání. Typický Shopteťák chce v článku odkázat na „červené dámské mikiny“, otevře kategorii, nakliká filtr červená, zkopíruje URL obsahující ?pv... a vloží ji do článku. Hotovo. Bohužel také právě vytvořil interní odkaz na adresu, kterou robots.txt blokuje.
Pokud má daný filtr vyhledávací potenciál a chcete ho používat jako landing page, vytvořte z něj přes Pokročilé SEO samostatnou indexovatelnou URL. Pokud potenciál nemá, necpěte ji do interního prolinkování jen proto, že ji prohlížeč umí otevřít.
To samé platí pro interní vyhledávání. URL výsledků vyhledávání není náhrada kategorie. Pokud máte potřebu často odkazovat na vyhledávání „náhradní díly Jawa 350“, možná vám tím e-shop právě velmi zdvořile naznačuje, že byste měli vytvořit skutečnou kategorii nebo parametrickou landing page.
Mohu do robots.txt přidat vlastní kategorii?
Ano, Shoptet umožňuje přidat vlastní pravidla na konec robots.txt a existují situace, kdy to dává smysl. Typickým příkladem mohou být pomocné technické kategorie používané při napojení skladů, ERP, Pohody, Heliosu nebo jiných můstků mezi systémy, které nemají hodnotu pro vyhledávače.
Pokud máte například speciální veřejnou pomocnou URL, o které stoprocentně víte, že ji nechcete crawlovat, lze ji individuálně zakázat. Ale právě ono „stoprocentně víte“ je podstatné. Nezakazujte kategorii jen proto, že ji dnes nepotřebujete v Googlu. Za půl roku z ní může být důležitá landing page a nikdo už si nevzpomene, že ji předchozí správce před dvěma lety schoval v robots.txt.
User-agent: *
Disallow: /pomocna-b2b-kategorie/
Pokud má ale obsah být skutečně neveřejný, nepoužívejte robots.txt jako zabezpečení. Adresa robots.txt je veřejná a každý si v ní naopak může přečíst seznam cest, které nechcete robotům ukazovat.
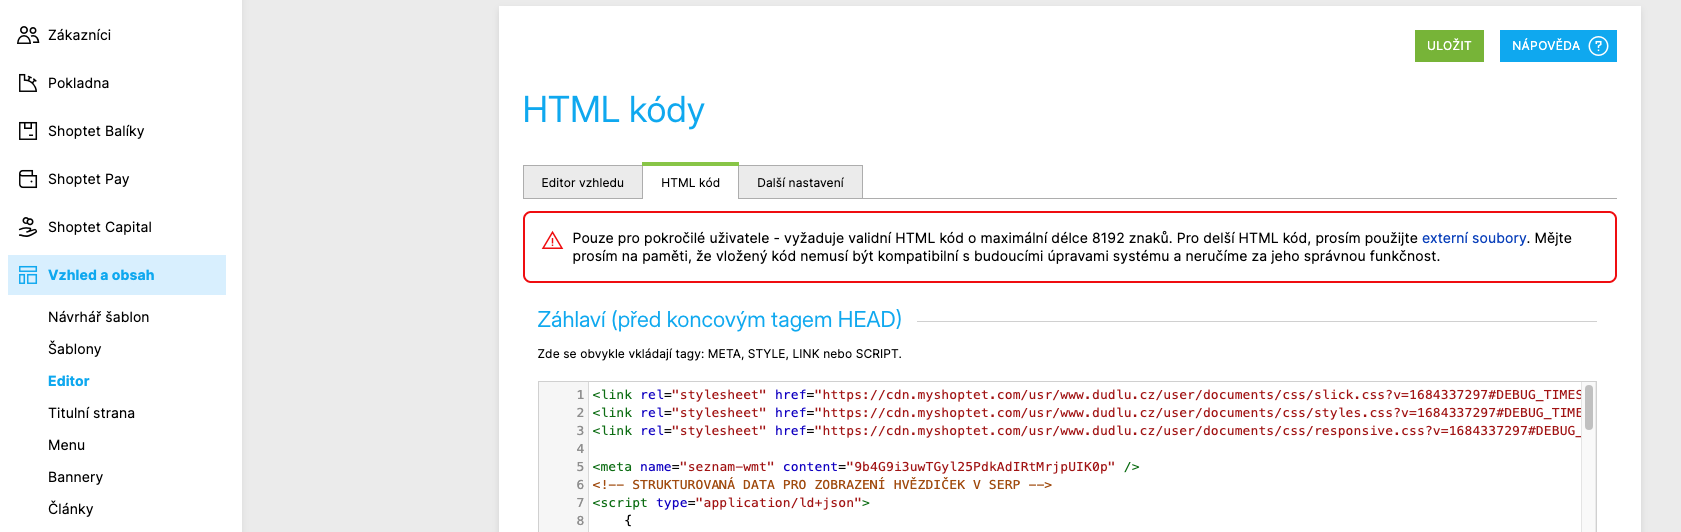
ROBOTS.TXT najdete v sekci Shoptet > Vzhled a obsah > Editor > HTML kód
Co jsou nové Content Signals v Shoptetu?
V roce 2026 Shoptet přidal k nastavení robots.txt také Content Signals. Jde o novější mechanismus vycházející ze specifikace Content Signals podporované Cloudflarem, který umožňuje provozovateli webu strojově vyjádřit preferenci, jak smějí automatizované systémy jeho obsah používat.
Nejde o klasické Allow a Disallow pro samotný crawling. Content Signals mají popsat, co se smí s již dostupným obsahem dělat. A to ve třech samostatných oblastech: klasické vyhledávání, použití obsahu jako vstupu do AI odpovědí a využití pro trénování modelů.
| Signal | Význam | Moje doporučení |
|---|---|---|
| search | Budování vyhledávacího indexu, odkazy a klasické úryvky | Povolit |
| ai-input | Využití obsahu jako vstupu pro AI odpovědi, RAG nebo grounding | Povolit |
| ai-train | Využití obsahu pro trénování nebo dolaďování AI modelů | Povolit |
Osobně u e-shopů doporučuji nastavit všechny tři možnosti na Povolit. Mým cílem u klientů není produktové popisky, poradny a informace o sortimentu schovávat. Naopak chci, aby značka měla co největší šanci být čitelná, dohledatelná a použitelná v klasických i AI vyhledávacích systémech.
U search a ai-input je pro mě volba jednoznačná. Pokud provozujete e-shop, chcete být nalezeni ve vyhledávači a chcete mít možnost být použiti jako zdroj pro odpověď AI, musíte povolit.
U ai-train je potřeba říct jednu důležitou věc: povolení trénování není podmínkou pro zobrazování v AI odpovědích. Tyto dvě oblasti jsou právě proto oddělené. Pokud máte unikátní placený obsah, know-how nebo z nějakého důvodu nechcete poskytovat obsah pro trénink modelů, je naprosto legitimní nastavit ai-train=no a současně ai-input=yes.
U klasického produktového e-shopu ale osobně dávám přednost maximální dostupnosti. Produktový popisek sekery, dětského kočárku nebo gumy rozety není moje tajná receptura Coca-Coly.
Pokud nastavíte všechny tři oblasti na Povolit, výsledkem může být deklarace následujícího typu:
Content-Signal: search=yes, ai-input=yes, ai-train=yesPokud byste chtěli povolit klasické vyhledávání a AI odpovědi, ale zakázat trénování, použije se logika:
Content-Signal: search=yes, ai-input=yes, ai-train=noHodnota „Nenastaveno“ neznamená zákaz. Znamená, že prostřednictvím Content Signals danou preferenci vůbec nevyjadřujete. Podle vysvětlení Shoptetu v debatě se Shoptet partnery se každá možnost do robots.txt zapisuje pouze tehdy, když ji uživatel / SEO specialista explicitně nastaví.

Ukázka nastavení Robots.txt pro AI v Shoptetu našeho e-shopu Dudlu
V Robots.txt není místo pro kreativitu
Robots.txt je jeden z těch SEO souborů, kde je nuda velmi pozitivní vlastnost. Pokud používáte Shoptet, máte výhodu, že jeho základní nastavení už řeší nejčastější technické cesty, parametry, interní vyhledávání a další URL, které robotům servírovat nechceme.
Nejdůležitější je vědět, že Disallow neznamená automatický zákaz indexace, robots.txt není bezpečnostní ochrana a interní odkazy na zakázané URL jsou zbytečně matoucí. U parametrické navigace raději vytvářejte skutečné SEO landing pages, technické adresy nechte blokované a do vlastních pravidel zasahujte pouze tehdy, když dokážete vysvětlit, co přesně daná řádka udělá.
Nové Content Signals beru jako užitečnou možnost deklarovat, že e-shop chce svůj veřejný obsah zpřístupnit také novým způsobům vyhledávání a práce s AI. U běžných e-shopů proto preferuji povolení, zatímco samotné technické crawlingové restrikce Shoptetu bych nechal dál dělat svoji práci.
Tak nezahálejte, aktualizujte si Robots.txt ať i vám e-shopy rostou — celý seriál zde!
Nejčastější dotazy k robots.txt
Soubor robots.txt pomáhá řídit, kam se mají vyhledávače a další roboti na webu dívat. Špatné nastavení ale může zbytečně blokovat důležité stránky, SEO i AI dohledatelnost.


0 komentářů